
Whisper на VPS: распознавание речи без видеокарты (faster-whisper, CPU)
Whisper — открытая модель, которая превращает речь в текст. Запустить Whisper на VPS без видеокарты можно: для этого есть faster-whisper, программа на Python, которая считает модель на обычном процессоре. Ниже — установка с нуля, готовый скрипт и таблица замеров: сколько памяти и времени уходит у моделей tiny, base и small. Ещё одна находка: сразу после установки распознавание падает с ошибкой, и лечится она одной командой. Какой именно, покажем ниже.
Всё выполнялось 13 ноября 2026 года на свежем сервере Ubuntu 24.04.5 с двумя vCPU и 4 ГБ памяти (free показывает 3,9 ГБ), диск 38 ГБ. Версии: faster-whisper 1.2.1, ctranslate2 4.9.0, Python 3.12 из самой Ubuntu. На других версиях Ubuntu мы не пробовали.
Что получится и чего мы не проверяли
Получится программа, которой вы отдаёте звуковой файл, а она возвращает текст. Мы измеряли две вещи: скорость и расход памяти. Качество распознавания русской речи мы не проверяли: замеры шли на английской записи. Проверку на русском синтетическим голосом мы тоже делали, но она показала только мусор в тексте, и делать из неё выводы нельзя (подробности в разделе про русский язык). Видеокарты (GPU), модели medium и large, фильтр пауз (VAD) и сохранение субтитров мы не пробовали. Всё это за рамками статьи.
Что такое Whisper и faster-whisper
Модель — файл с «знаниями» нейросети, он скачивается один раз и лежит на диске. У Whisper их несколько размеров: tiny (самая маленькая), base, small и больше. Чем крупнее модель, тем больше она занимает места и памяти и тем медленнее считает.
faster-whisper — программа, которая запускает эти модели. Считает она через библиотеку CTranslate2, та ставится сама вместе с ней. Сравнивать её с оригинальным Whisper по скорости мы не стали, так что слово «быстрее» здесь только из названия.
Для процессора важен режим int8: числа модели хранятся в восьмибитном виде, и обычно это экономит память и ускоряет счёт на процессоре. Скорость и точность с другими режимами мы не сравнивали.
Какой VPS нужен под Whisper
Видеокарта не обязательна, но нужны процессорные ядра и память. Вот что мы увидели на двух vCPU (подробнее в таблице ниже): самой маленькой модели хватило 359 МБ памяти, самой большой из проверенных (small) понадобилось 1,33 ГБ. Места на диске нужно немного: модели занимают от 75 до 464 МБ, а виртуальное окружение вместе с зависимостями — около 485 МБ. Выбирать тариф удобнее по памяти и числу ядер, подробнее — в статье про выбор тарифа. Посмотреть варианты можно на странице VPS UFO.Hosting.
Если памяти впритык, заранее добавьте swap: это файл на диске, который система использует как запас, когда оперативная память кончается. Как сделать, написано в статье про swap-файл. Серверы с 2 ГБ памяти и меньше мы в этом лабе не брали.
Шаг 1. Пакеты из apt
Нам нужны два пакета. ffmpeg — набор инструментов для работы со звуком, с ним удобно конвертировать и склеивать записи. python3-venv позволяет создать виртуальное окружение: отдельную папку с собственными библиотеками Python, чтобы установка не засоряла систему.
$ sudo apt update
$ sudo apt install -y ffmpeg python3-venv
Проверка: ffmpeg -version должен ответить строкой вроде ffmpeg version 6.1.1-3ubuntu5 (такая версия была у нас на 24.04).
Шаг 2. Окружение и faster-whisper
Создаём окружение в /opt/whisper/venv и ставим в него faster-whisper. Мы работали под root. Если вы входите обычным пользователем, сначала создайте каталог и отдайте его себе: sudo mkdir -p /opt/whisper && sudo chown $USER /opt/whisper. Подробнее об окружениях — в статье про Python venv.
$ python3 -m venv /opt/whisper/venv
$ /opt/whisper/venv/bin/pip install faster-whisper
Мы вызываем pip по полному пути из окружения, поэтому активировать его не нужно: пакеты попадут именно туда. На нашем сервере установка faster-whisper заняла 16 секунд. Проверить версию можно так:
$ /opt/whisper/venv/bin/pip show faster-whisper | sed -n 2p
Version: 1.2.1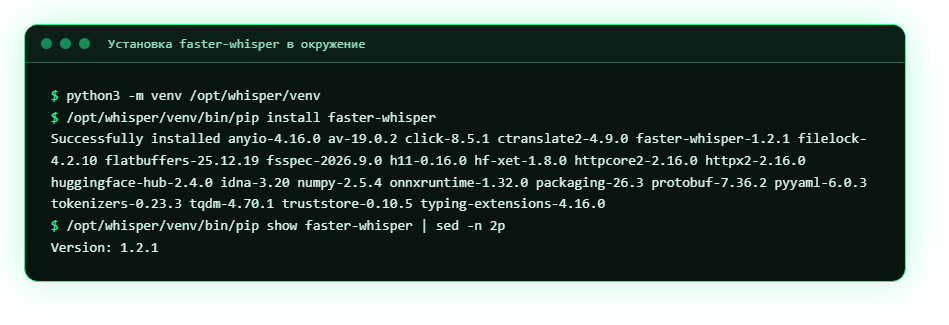
Шаг 3. Скрипт распознавания
Создайте файл /opt/whisper/transcribe.py (например, nano /opt/whisper/transcribe.py) и вставьте в него:
import sys, time
from faster_whisper import WhisperModel

path, name, lang = sys.argv[1], sys.argv[2], sys.argv[3]

t0 = time.time()
m = WhisperModel(name, device="cpu", compute_type="int8", cpu_threads=2)
t1 = time.time()
segs, info = m.transcribe(path, language=lang, beam_size=1)
text = " ".join(s.text.strip() for s in segs)
t2 = time.time()

print("model=%s load=%.1fs transcribe=%.1fs audio=%.1fs x_realtime=%.2f words=%d" % (name, t1 - t0, t2 - t1, info.duration, info.duration / (t2 - t1), len(text.split())))
print("text:", text)
Скрипт принимает три слова: путь к записи, имя модели и язык. Что в нём важно:
device="cpu"— считать на процессоре, видеокарта не нужна.compute_type="int8"— тот самый экономный режим из раздела выше.cpu_threads=2— сколько ядер занять. У нас два vCPU; своё число покажет командаnproc.beam_size=1— модель не перебирает несколько вариантов расшифровки, а идёт по одному. Это экономит время. Как это сказывается на точности, мы не проверяли.language=lang— язык задан явно (en,ru), как в наших замерах.- Время
t2берётся после" ".join(...)не случайно:transcribeвозвращает «ленивый» генератор фрагментов, и сам счёт идёт, пока вы по нему проходите.
Шаг 4. Первый запуск и ловушка с av
Загрузите на сервер свою запись (например, scp zapis.wav root@IP_СЕРВЕРА:/opt/whisper/ с вашего компьютера) и запустите. При первом запуске выбранная модель скачивается из интернета, поэтому он идёт дольше остальных. Мы брали wav 16 кГц, один канал. Другие форматы не пробовали.
$ cd /opt/whisper
$ /opt/whisper/venv/bin/python transcribe.py zapis.wav base en
На нашем сервере, на свежей установке, вместо текста пришло вот что:
TypeError: open() got an unexpected keyword argument 'metadata_errors'Это не ваша ошибка и не ошибка в скрипте. faster-whisper читает звук через библиотеку av и вызывает её с параметром metadata_errors. У нас pip подтянул av версии 19.0.2, и такого параметра она не принимает. Лечится установкой более старой версии:
$ /opt/whisper/venv/bin/pip install 'av<16'
$ /opt/whisper/venv/bin/pip show av | sed -n 2p
Version: 15.1.0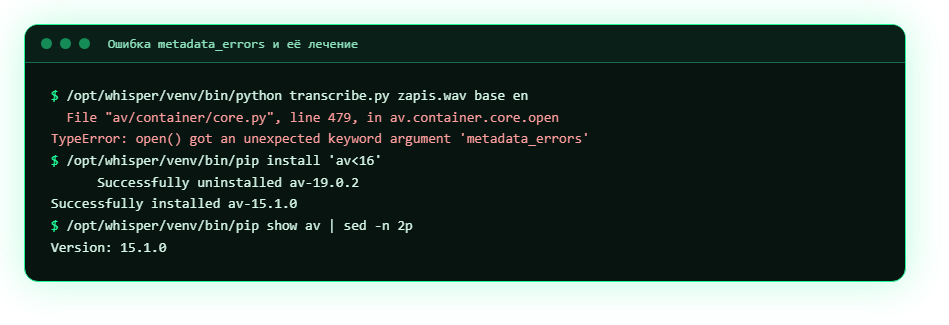
Кавычки вокруг 'av<16' обязательны: без них оболочка прочтёт < как перенаправление ввода. После этого скрипт заработал. Возможно, со временем в faster-whisper это поправят: сначала запустите скрипт, а команду выше выполняйте, только если увидели эту ошибку.
Если всё хорошо, результат такой (это наш запуск с base, текст сокращён):
model=base load=0.9s transcribe=20.3s audio=55.0s x_realtime=2.71 words=110
text: And so my fellow americans ask not what your country can do for you ask what you can do for your country and so my fellow americans ask not what your country can do for you ask what you can do for your country and so my fellow americans ask not what your ...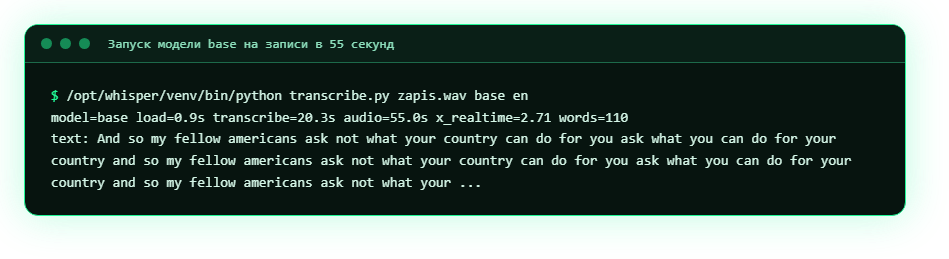
Расшифровка: load — сколько модель загружалась с диска (у нас 0,7-1,9 секунды), transcribe — сколько считалась запись, x_realtime — во сколько раз быстрее реального времени (2,70 значит, что 55 секунд звука обработаны за 20,4).
Сколько памяти и времени нужно: замеры
Запись для замеров — английская речь длиной 55 секунд (короткий фрагмент, склеенный пять раз). Режим тот же: int8, cpu_threads=2, beam_size=1, язык задан явно. Модели запускались по одной. Пик памяти мы снимали командой /usr/bin/time -f "peak_rss_kb=%M", поставленной перед вызовом Python.
| Модель | На диске | Пик памяти | 55 секунд звука обработаны за | Быстрее реального времени в |
|---|---|---|---|---|
| tiny | 75 МБ | 359 МБ | 10,3 с | 5,36 раза |
| base | 142 МБ | 541 МБ | 20,4 с | 2,70 раза |
| small | 464 МБ | 1,33 ГБ | 35,1 с | 1,57 раза |
Что из этого следует. Память растёт вместе с моделью: у small она в три с лишним раза больше, чем у tiny. Скорость падает примерно так же. Даже small на двух ядрах работает быстрее реального времени. Для оценки: если скорость сохранится на длинных записях (их мы не гоняли), час звука займёт у tiny около 11 минут, у base около 22, у small около 38. Это грубая прикидка по таблице, а не замер.
А как с русским языком
Честно: на живой русской записи мы ничего не измеряли. Все цифры таблицы относятся к английской записи. Единственный русский тест был на голосе синтезатора espeak-ng. Модель tiny выдала на нём бессвязный набор слов вперемешку с посторонними символами и работала заметно медленнее, чем на английской записи (около 1,6 раза быстрее реального времени вместо 5,4). Синтетический голос звучит иначе, чем человек, поэтому вывод «tiny плохо понимает русский» отсюда делать нельзя, как и обратный.
Что делать вам: возьмите свою запись (минуту-две, с обычным для вас качеством звука) и прогоните её через две модели, например base и small, с ru в третьем аргументе:
$ /opt/whisper/venv/bin/python transcribe.py moya_zapis.wav small ruСравните текст с тем, что слышите сами, и выберите самую лёгкую модель, которая вас устраивает. Так вы и память сэкономите, и сами убедитесь в качестве.
Когда какую модель брать
- Сервер с небольшим запасом памяти. Начинайте с tiny или base: им хватило 359 и 541 МБ.
- Важнее текст, чем скорость. Пробуйте small, но помните про пик в 1,33 ГБ: оставьте запас под систему и свои сервисы и включите swap.
- Много длинных записей. Считайте время по таблице: именно оно ограничивает, сколько записей сервер переварит за сутки.
Одновременный запуск нескольких распознаваний на двух ядрах мы не проверяли. Логично ожидать, что они будут делить процессор и замедлять друг друга, но это предположение.
Частые вопросы
Нужна ли видеокарта для Whisper?
Для faster-whisper в режиме int8 на процессоре нет: мы запускали его на VPS с двумя vCPU без видеокарты и получили работающее распознавание. Как поведёт себя на GPU, мы не проверяли.
Откуда ошибка open() got an unexpected keyword argument metadata_errors?
В окружении оказалась слишком новая библиотека av (у нас 19.0.2), которая не принимает параметр metadata_errors. Команда pip install 'av<16' ставит более старую (у нас 15.1.0), после чего всё работает.
Сколько места занимают модели?
На диске tiny занимает 75 МБ, base 142 МБ, small 464 МБ. Скачиваются они при первом запуске. Само окружение с faster-whisper и зависимостями у нас заняло около 485 МБ.
Как понять, хватит ли серверу памяти?
Запустите /usr/bin/time -f "peak_rss_kb=%M" /opt/whisper/venv/bin/python transcribe.py ...: в конце появится пик памяти в килобайтах. Для нашего small это было около 1 330 000, то есть 1,33 ГБ. Прибавьте запас под систему и свои сервисы.
Коротко
- Whisper через faster-whisper работает на VPS без видеокарты: нужны
ffmpegиpython3-venv, а установка самого faster-whisper заняла у нас 16 секунд. - Сразу после установки возможна ошибка
metadata_errors. Помогаетpip install 'av<16'. - На двух vCPU и английской записи в 55 секунд: tiny 10,3 с и 359 МБ, base 20,4 с и 541 МБ, small 35,1 с и 1,33 ГБ.
- Качество на русской речи мы не измеряли. Проверьте на своей записи.
- Не проверяли: видеокарту, модели medium и large, фильтр пауз, субтитры, параллельные запуски, серверы с памятью до 2 ГБ.
Похожее
Все статьи
Nextcloud на VPS: своё облако через Docker Compose
Nextcloud — это собственное облако: файлы с синхронизацией на телефон и компьютер, календарь, контакты, общий доступ по ссылке. На VPS его поднимают через Docker Compose из пяти контейнеров (подробности ниже): Nextcloud, база PostgreSQL, кэш Redis, контейнер для фоновых задач и…
n8n на VPS: установка через Docker Compose, HTTPS и автозапуск
n8n на своём VPS поднимается через Docker Compose за один вечер: два контейнера (сам n8n и обратный прокси Caddy, который сам выпускает HTTPS-сертификат), три небольших файла и одна команда запуска. Ниже — готовые файлы, объяснение каждой переменной, первый сценарий с…